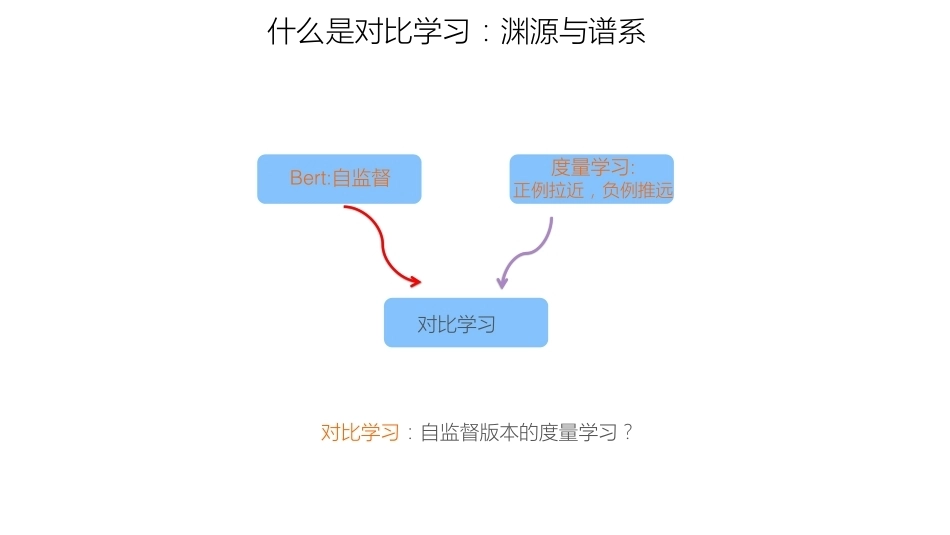
Outline典型对比学习模型02对比学习视角来看召回/粗排模型03什么是对比学习01什么是对比学习:渊源与谱系Bert:自监督度量学习:正例拉近,负例推远对比学习对比学习:自监督版本的度量学习?什么是对比学习:一个抽象的对比学习系统Loss Function:InfoNCE什么是对比学习:一个抽象的对比学习系统关键问题:1.正例怎么构造?负例怎么构造?2.映射函数f怎么设计?3.损失函数怎么设计?什么是对比学习:典型例子-SimCLR要做L2Norm关键问题:1.正例怎么构造?负例怎么构造?2.映射函数f怎么设计?3.损失函数怎么设计?什么是对比学习:怎样是一个不好的对比学习系统?关键问题:如何防止模型坍塌?我要我们在一起什么是对比学习:怎样是一个好的对比学习系统?什么是对比学习:SimCLR怎么防止坍塌的?Loss Function:InfoNCE通过负例!注意:1.负例越多模型效果越好,请记住这个结论2.温度系数对结果影响很大,通常比较小的数值,0.01—0.1,为什么?Outline典型对比学习模型0203什么是对比学习01对比学习视角来看召回/粗排模型图像对比学习:Batch内负例-SimCLRHighLights:ü 双塔结构ü Embedding L2 Normü 自动构造正例ü In-Batch负例图像对比学习:Batch外负例-MoCoQuestion:怎样增加负例数量?Momentum:图像对比学习:基于负例方法谱系相互借鉴,目前的共识:1.网络结构:双塔2.映射函数F: Encoder+Projector3.Encoder越来越复杂图像对比学习:对比聚类-SwAVOutline典型对比学习模型02对比学习视角来看召回/粗排模型03什么是对比学习01ü 重新审视召回/粗排模型ü 更纯正的对比学习ü 对比学习-图召回重新审视召回/粗排模型:双塔模型-概述优点:ü 简单ü 在线ANN检索速度快DNN双塔召回/粗排模型缺点:ü User侧和Item侧特征交互太晚ü 效果不及排序模型三个实践经验决策点:ü 召回模型负例如何选择ü User Embedding和Item Embedding要做Norm?ü Loss中相似性计算中要带温度超参么?重新审视召回/粗排模型:双塔模型-负例问题Selection Bias问题DNN双塔召回/粗排模型召回负例可能做法:ü In-Batch 负例(Google DNN双塔)ü 全局随机抽样(Youtube DNN)ü Mix{In-Batch负例+全局随机抽样}(Google)ü Mix{In-Batch+曝光未点击}{我们19年做FM召回时的做法}假设我们采取In-Batch负例重新审视召回/粗排模型:Embedding Norm决策点:对User Embedding和Item Embedding要做Norm么?Option1:Inner ProductionOption 2:CosineDNN双塔召回/粗排模型经验结果:要做(我们实验过Norm确实效果好一些)From: Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations为什么?有没有解释?重新审视召回/粗排模型:温度超参决策点:Loss函数里或者User和Item相似性计算要加入温度超参么?Option1:不加温度超参Option 2:加温度超参温度超参的影响经验结果:最好加(我们实验过加温度超参确实效果好一些)From: Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations为什么?有没有解释?重新审视召回/粗排模型:其实目前的双塔就是一种对比学习决策点:ü User Embedding/Item Embedding做Normü Loss带温度超参ü In-Batch负例DNN双塔召回/粗排模型可以把当前的召回模型看作是对比学习系统重新审视召回/粗排模型:Recap-SimCLRLoss Function:InfoNCE决策点:ü Embedding做Normü Loss带温度超参ü In-Batch负例如果把正例方式换掉/图像编码Encoder去掉,我们可以复现出双塔召回模型!重新审视召回/粗排模型:用对比学习解释经验做法ü 对比学习视角:In-Batch负例的作用是什么?ü 对比学习视角:温度超参的作用是什么?ü 对比学习视角:User Embedding和Item Embedding为何要做Norm?灵魂三问:重新审视召回/粗排模型:双塔模型负例的作用是什么?从对比学习的观点来看:ü 增强User Embedding和Item Embedding映射到投影空间内的Uniformityü Uniformity:保留每个实体(User/Item)个性化细粒度信息ü Uniformity:防止模型坍塌ü 推论:Batch Size越大效果越好重新审视召回/粗排模型:温度超参的作用是什么?From: Understanding the Behaviour of Contrastive LossCIFAR10数据:小的温度超参增加数据分布的UniformityLoss Function:InfoNCE梯度分析:误分概率:说明了:温度超参可以将Loss聚焦在Hard负例重新审视召回/粗排模型:温度超参的作用是什么?From: Understanding the Behaviour of Contrastive Loss说明了:如果温度超参越小,则将Hard负例在投影空间从Anchor推开能量越大推论:召回模型的温度超参应该也是类似的作用,小的温度超参将优化过程自动聚焦到Hard负例推论:可以再思考下召回模型的随机负例,引入温度超参可能更重要:Easy Example vs Hard Example推论:使用温度超参,其实你不用专门去挖掘Hard Neg Example重新审视召回/粗排模型:Embedding为什么要做Norm?From: Understanding the Behaviour of Contrastive Loss单位超球面:增加训练稳定性以及线性可分性重新审视召回/粗排模型:搞点新意思ü 前面我们从对比学习角度来看待双塔模型,并对经验结果做了解释ü 能从对比学习角度,搞点不一样的召回模型么?重新审视召回/粗排模型:搞点新意思SENet双塔模型推荐领域使用SENetFrom: FiBiNET: combining feature importance and bilinear feature interaction for click-through rate prediction后续改进:MaskNet: Introducing Feature-Wise Multiplication to CTR Ranking Models by Instance-Guided Mask后续改进:ContextNet: A Click-Through Rate Prediction Framework Using Contextual information to Refine Feature Embedding重新审视召回/粗排模型:搞点新意思正在做的ConCAT模型:ü User-action-Item:User行为过Item过做正例ü User Batch & Item Batch经过DNNü 对User Batch & Item Batch聚类,形成类中心(混合聚类vs.分别聚类)ü Loss-user:某个User embedding要求预测对应Item正例所属的类;ü Loss-item:某个Item embedding要求预测对应User正例所属的类;ü Swap Loss:Loss-user+Loss-itemü 推荐领域版本的SwAVContrasting Cluster Assignment Two-Tower(ConCAT)思考题:推荐系统有足够多训练数据,好像不需要对比学习吧?用户行为数据分布极度不均匀:长尾分布更纯正的对比学习:双塔模型-Item侧引入对比辅助LossFeature DropOut版正例:Item Feature Set随机Drop掉一部分From: Self-supervised Learning for Large-scale Item Recommendations更纯正的比学习:双塔模型-Item侧引入对比辅助LossFeature Mask版正例:Item Feature Set划分为不同子集合From: Self-supervised Learning for Large-scale Item Recommendations更纯正的对比学习:双塔模型-Item侧引入对比辅助Loss实验结果:ü 在不同数据集合都有提升ü 对于数据稀疏场景尤其有效。From: Self-supervised Learning for Large-scale Item Recommendations更纯正的对比学习:双塔模型-User侧和Item侧同时引入对比辅助LossItem Side Contrastive LossUser Side Contrastive Loss更彻底的对比学习召回/粗排模型:ü Item侧对比学习辅助Loss(Feature Mask or Feature Dropout)ü User侧对比学习辅助Loss(Feature Mask or Feature Dropout)ü 应该可以缓解数据稀疏的User/Item对应Embedding质量ü 正例构造方式:可以有其它技术方案ü 对于User侧的行为序列:可以引入GNN Contrastive Lossü 我们正在尝试这个方案快速存取对比学习-图模型召回:整体结构图GNN模型离线:在线执行:User FeatureItem FeatureUser EmbeddingItem EmbeddingUser log inUser EmbeddingItem 1Item 2快速存取(Say:Faiss)Item 3图模型召回:使用GNN来打Embedding对比学习-图模型召回:GNN图的构造:用户行为图User/Item Embedding:GCN基于对比学习的图计算:例子一From: Graph Contrastive Learning with Augmentations对比学习-图模型召回:图结构如何构造正例常见构造方法:ü 随机抛掉部分节点或者边ü 随机插入噪音边或者去掉部分边ü Mask节点属性ü 随机Walk构造不同子图基于对比学习的图计算:例子二From: Graph Contrastive Learning with Adaptive Augmentation对比学习-图模型召回:如何用在召回?图的构造:用户行为图Contrastive GNNUser Embedding & Item Embedding图模型召回思考题:可以在Ranking阶段引入对比学习么?当然可以+Contrastive Loss+如何构造正例负例




发表评论取消回复